

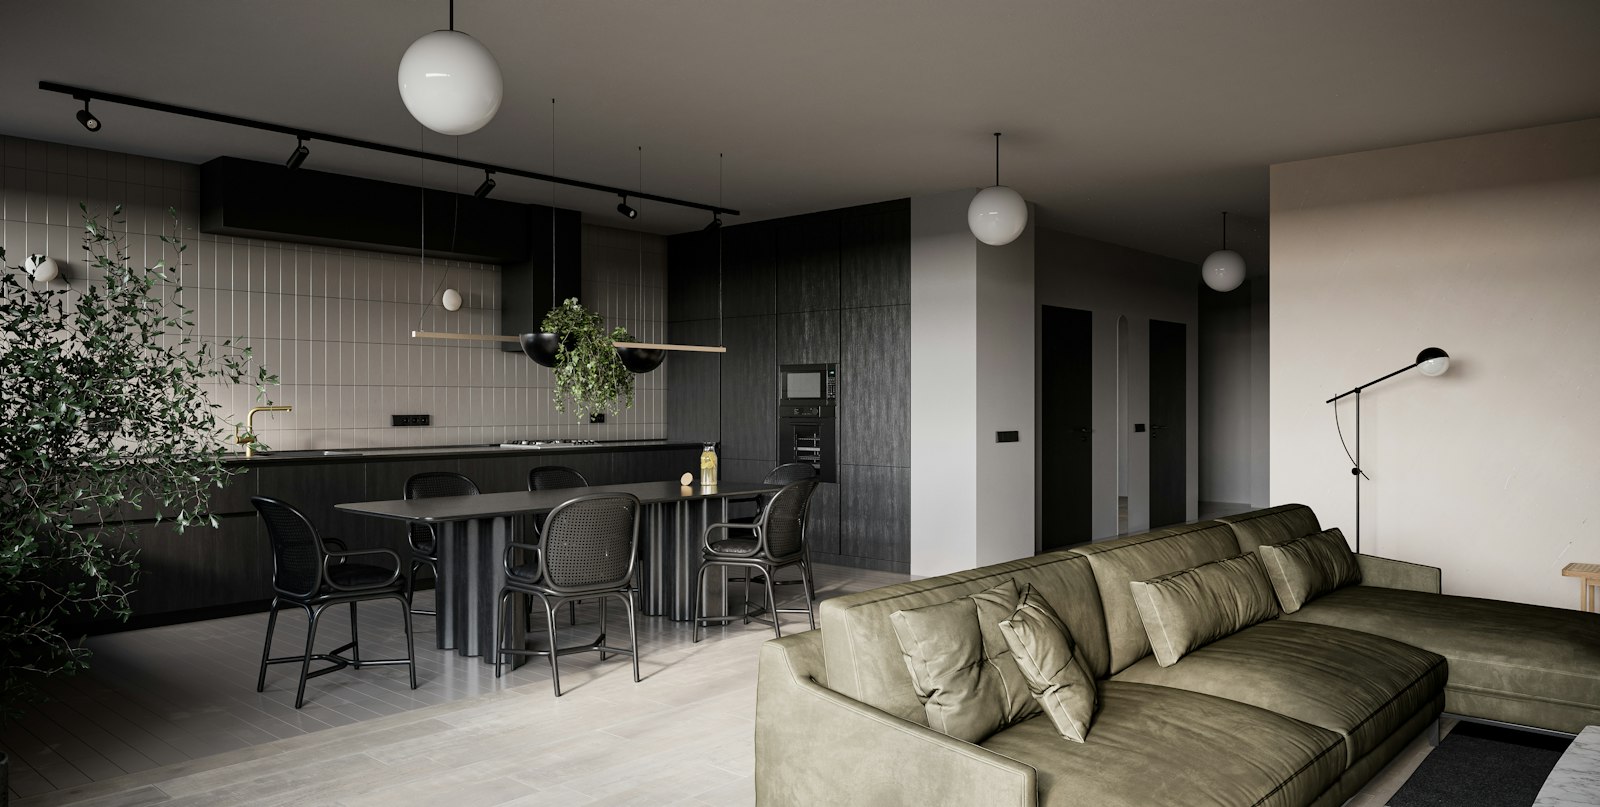
Ein Foto als Ausgangspunkt, eine bearbeitbare 3D-Szene als Ergebnis: LEGO-Anything untersucht, wie KI-Agenten diese Übersetzung mit Blender-Code leisten können. Die Forschungsarbeit von Beteiligten der University of Maryland und AWS wurde am 28. September 2026 auf arXiv veröffentlicht und wird jetzt öffentlich diskutiert. Interessant ist weniger das nächste hübsche Vorschaubild als die Möglichkeit, Gegenstände, Kamera und Raumaufteilung anschließend gezielt zu verändern.
Das Wichtigste in Kürze
- LEGO-Anything lässt einen Agenten Blender-Code schreiben, ausführen, rendern und schrittweise überarbeiten.
- LEGO-Bench prüft 208 Bilder aus 104 simulierten Szenen. Funktionsfähige Dateien und inhaltliche Treue werden getrennt bewertet.
- GPT-6-astra mit Codex erreicht 53,4 Prozent im Innenraum- und 39,6 Prozent im Außenbereich-Gesamtwert. Das sind keine allgemeinen Genauigkeitsquoten für echte Fotos.
- Eine zusätzliche Steuerung namens LEGO-Plugin verbessert die untersuchten Agenten auf einem begrenzten Büro-Teilbestand, ohne die Modelle neu zu trainieren.
- Die Projektseite kündigt den Code noch als demnächst verfügbar an. Das Forschungsprojekt ist deshalb noch kein fertig herunterladbares Werkzeug für den Alltag.
Warum eine Szene als Programm mehr Möglichkeiten eröffnet
Eine computergenerierte Ansicht kann einen Raum überzeugend darstellen, ohne eine brauchbare räumliche Beschreibung zu liefern. Für die weitere Arbeit macht das einen großen Unterschied. Wer einen Tisch verschieben, eine Kamera neu ausrichten oder einzelne Objekte austauschen möchte, braucht mehr als die Pixel eines Bildes. Ein ausführbares Szenenprogramm hält solche Elemente ausdrücklich fest und kann nach einer Änderung erneut ein Bild berechnen.
LEGO-Anything setzt dafür einen allgemeinen Programmieragenten ein. Er deutet das Referenzbild, plant die Szene, schreibt Blender-Code und betrachtet das berechnete Ergebnis. Anschließend kann er die Konstruktion ändern. Diese Schleife verbindet sprachliche Aufgabenbeschreibung mit einem kontrollierbaren Arbeitsprodukt: Man kann das Programm lesen, Teile davon ändern und seine Wirkung erneut prüfen. Das Ergebnis bleibt damit prinzipiell weiterbearbeitbar, statt nur als fertige Ansicht vorzuliegen.
Für Entwurf und Visualisierung ist das eine interessante Richtung. Als mögliches Arbeitsbeispiel könnte eine grobe Raumrekonstruktion helfen, verschiedene Möbelanordnungen zu diskutieren. Ob die Maße stimmen, wäre eine weitere Frage. Die Arbeit belegt keine vermessungsfähige Erfassung von Wohnungen und keine automatische Produktionsreife für Spiele oder Architektur. Gerade diese Trennung macht ihren Ansatz nützlich: Sie bewertet ausdrücklich, wie weit die ausgeführte Szene vom sichtbaren Vorbild entfernt bleibt.
Was die Prozentwerte tatsächlich messen
Der zugehörige Prüfparcours LEGO-Bench verwendet Bilder aus vollständig beschriebenen Simulator-Szenen. Dadurch kennt die Auswertung die richtige Geometrie und die Objektzuordnung, während der Agent diese Informationen nicht erhält. Der Datensatz umfasst 443 registrierte Assets, also wiederverwendbare Szenenbausteine. Für reale Fotografien wäre eine ähnlich genaue Vergleichsvorlage viel schwieriger zu gewinnen. Die simulierte Grundlage ermöglicht deshalb belastbare Messungen innerhalb des Versuchs, begrenzt aber die Übertragbarkeit auf beliebige Handyfotos.
Die Auswertung unterscheidet drei Fragen. Erstens: Lassen sich Szene, Export und berechnetes Bild überhaupt verwenden? Zweitens: Wie gut stimmen sichtbare Objektoberflächen mit der Vorlage überein? Drittens: Wie ähnlich sieht ein neu berechnetes Bild aus? Der Gesamtwert kombiniert die letzten beiden Größen; unbrauchbare Abgaben zählen mit null. Eine Szene kann also technisch erfolgreich entstehen und trotzdem Gegenstände, Abstände oder Kamerawinkel deutlich verfehlen.
GPT-6-astra mit Codex liegt unter den untersuchten Konfigurationen vorn. Die gemeldeten 53,4 Prozent für Innenräume und 39,6 Prozent für Außenszenen sind Mittelwerte über drei Durchläufe. Sie bedeuten weder, dass die Hälfte aller Räume korrekt rekonstruiert wurde, noch dass jede Entfernung zu 53,4 Prozent stimmt. Die Forschenden messen einen zusammengesetzten Wert unter ihren Versuchsbedingungen. Außenräume und komplexere Szenen bleiben schwieriger.
Auch eine Modellrangliste sollte man daraus nur für diese Aufgabe ableiten. Gemessen wird das Zusammenspiel aus Modell, Agentenumgebung und 3D-Werkzeug, nicht ein isoliertes Talent für jede Form räumlichen Denkens. Eine Verbesserung des Prüfwerts beweist außerdem keine Zeitersparnis im späteren Entwurfsprojekt. Dazu müsste bekannt sein, wie viel manuelle Nacharbeit das Ergebnis dort noch verlangt.
Warum Nachbessern manchmal Rückschritte produziert
Die Autoren untersuchen nicht nur die fertigen Dateien, sondern auch den Entstehungsweg. Wiederkehrende Schwierigkeiten sind ein schwacher Anfang, spätere Änderungen, die bereits richtige Teile beschädigen, und eine unzuverlässige Beurteilung des eigenen Ergebnisses. Besonders bei der Geometrie liegen die Modellurteile nahe am oder unter dem Zufallsniveau. Die Aufforderung, die Szene noch einmal sorgfältig anzusehen, ersetzt deshalb keinen verlässlichen Vergleich.
LEGO-Plugin ergänzt die Arbeitsumgebung um einen bildgestützten Start, konkrete Rückmeldungen zur Konstruktion und eine Kontrolle von Versionsständen. Eine Änderung wird geprüft und kann repariert oder zurückgenommen werden. Das ist keine neue Modellgeneration. Die Steuerung greift in den Ablauf ein und nutzt Informationen aus dem Referenzbild; die verborgene richtige Benchmark-Szene bleibt ihr unzugänglich.
Auf dem Büro-Teilbestand mit 42 Fällen verbessert diese Ergänzung alle sechs untersuchten Modelle. Der größte relative Zuwachs beträgt 62,7 Prozent, beim bereits stärksten Modell sind es 2,1 Prozent. Beide Angaben beziehen sich auf den jeweiligen Ausgangswert und diesen Teilversuch. Sie sind keine zusätzlichen Prozentpunkte und kein Versprechen für sämtliche Innen- und Außenszenen. Der Befund legt vielmehr nahe, dass bessere Arbeitsabläufe gerade schwächeren Agenten helfen können.
Für wen sich der Ansatz jetzt lohnt
Für 3D-Entwickler und Forschungsgruppen ist vor allem die überprüfbare Zwischenform interessant. Das Team leitet aus rekonstruierten Szenen auch Objekterkennung, Segmentierung und Tiefenschätzung ab. Die Resultate bleiben hinter spezialisierten Bildmodellen zurück. Trotzdem zeigt die Arbeit, dass dieselbe räumliche Beschreibung verschiedene Fragen beantworten kann, anstatt für jede Frage ein völlig neues Ergebnis zu erzeugen.
Wer praktisch mit agentengestütztem Blender experimentieren möchte, muss zwischen diesem Forschungsprojekt und vorhandenen Integrationen unterscheiden. Das separate Community-Projekt MCP for Blender kann Objekte bearbeiten, Materialien verändern und Python-Code in Blender ausführen; es stammt nicht von der Blender Foundation. Seine Verfügbarkeit bedeutet aber nicht, dass LEGO-Anything oder LEGO-Plugin damit bereits vollständig nachgebaut sind. Für lokale Experimente lohnt zudem ein Blick auf die Zugriffsrechte von Agenten auf dem Mac, bevor eine Arbeitsumgebung Zugriff auf eigene Projekte erhält.
Für den Einstieg in das Thema bietet die Projektseite bereits Vergleichsbilder und einen Betrachter der Messungen. Das ist derzeit der konkreteste Weg, die Stärken und Fehler des Ansatzes zu verstehen. Der nächste praktische Schritt hängt an der angekündigten Codefreigabe und daran, ob aus bearbeitbaren Rohszenen mit vertretbarer Nacharbeit brauchbare Entwürfe werden. Der eigentliche Fortschritt liegt im prüfbaren Arbeitsprodukt: Ein Bild wird zum Ausgangspunkt einer Konstruktion, über deren einzelne Teile man weiterarbeiten kann.