

Am Mittwochabend tauchten auf X vier Diagramme auf, die es zu diesem Zeitpunkt noch nicht geben sollte. Der Account BridgeMind veröffentlichte Screenshots aus einem OpenAI-Blogeintrag, der nach eigener Darstellung nur für Sekunden online war und dann wieder verschwand. Wenige Stunden später bestätigte sich, warum: OpenAI hat GPT-6 Astra offiziell vorgestellt. Die Zahlen sind beeindruckend, aber sie erzählen eine andere Geschichte als die Schlagzeile vom besten Modell der Welt.
Das Wichtigste in Kürze
- OpenAI hat GPT-6 Astra am 3. September 2026 veröffentlicht, zuerst für Geschäftskunden im Daybreak-Programm, danach für zahlende ChatGPT-Stufen, die API, AWS Bedrock und Azure.
- Kurz vor dem Start war eine Blogseite mit vier Benchmark-Diagrammen versehentlich erreichbar. Die dort abgebildeten Werte decken sich mit den offiziellen Angaben.
- Alle vier geleakten Diagramme zeigen Kosten- und Token-Kurven, keine reinen Bestenlisten. Astra liegt darin nicht überall vorn, aber fast immer deutlich weiter links.
- Bei mehreren Coding-Tests erreichen Claude-Modelle ähnliche oder leicht höhere Werte, brauchen dafür aber ein Vielfaches an Geld oder Rechenschritten.
- Bei Humanity’s Last Exam liegt Astra mit 57,2 Prozent fast acht Punkte hinter Claude Fable 5.1.
- Der Preis liegt bei 10 Dollar je Million Eingabe-Token und 50 Dollar je Million Ausgabe-Token, im schnelleren Modus beim Doppelten.
Wie die Zahlen vorzeitig ins Netz kamen
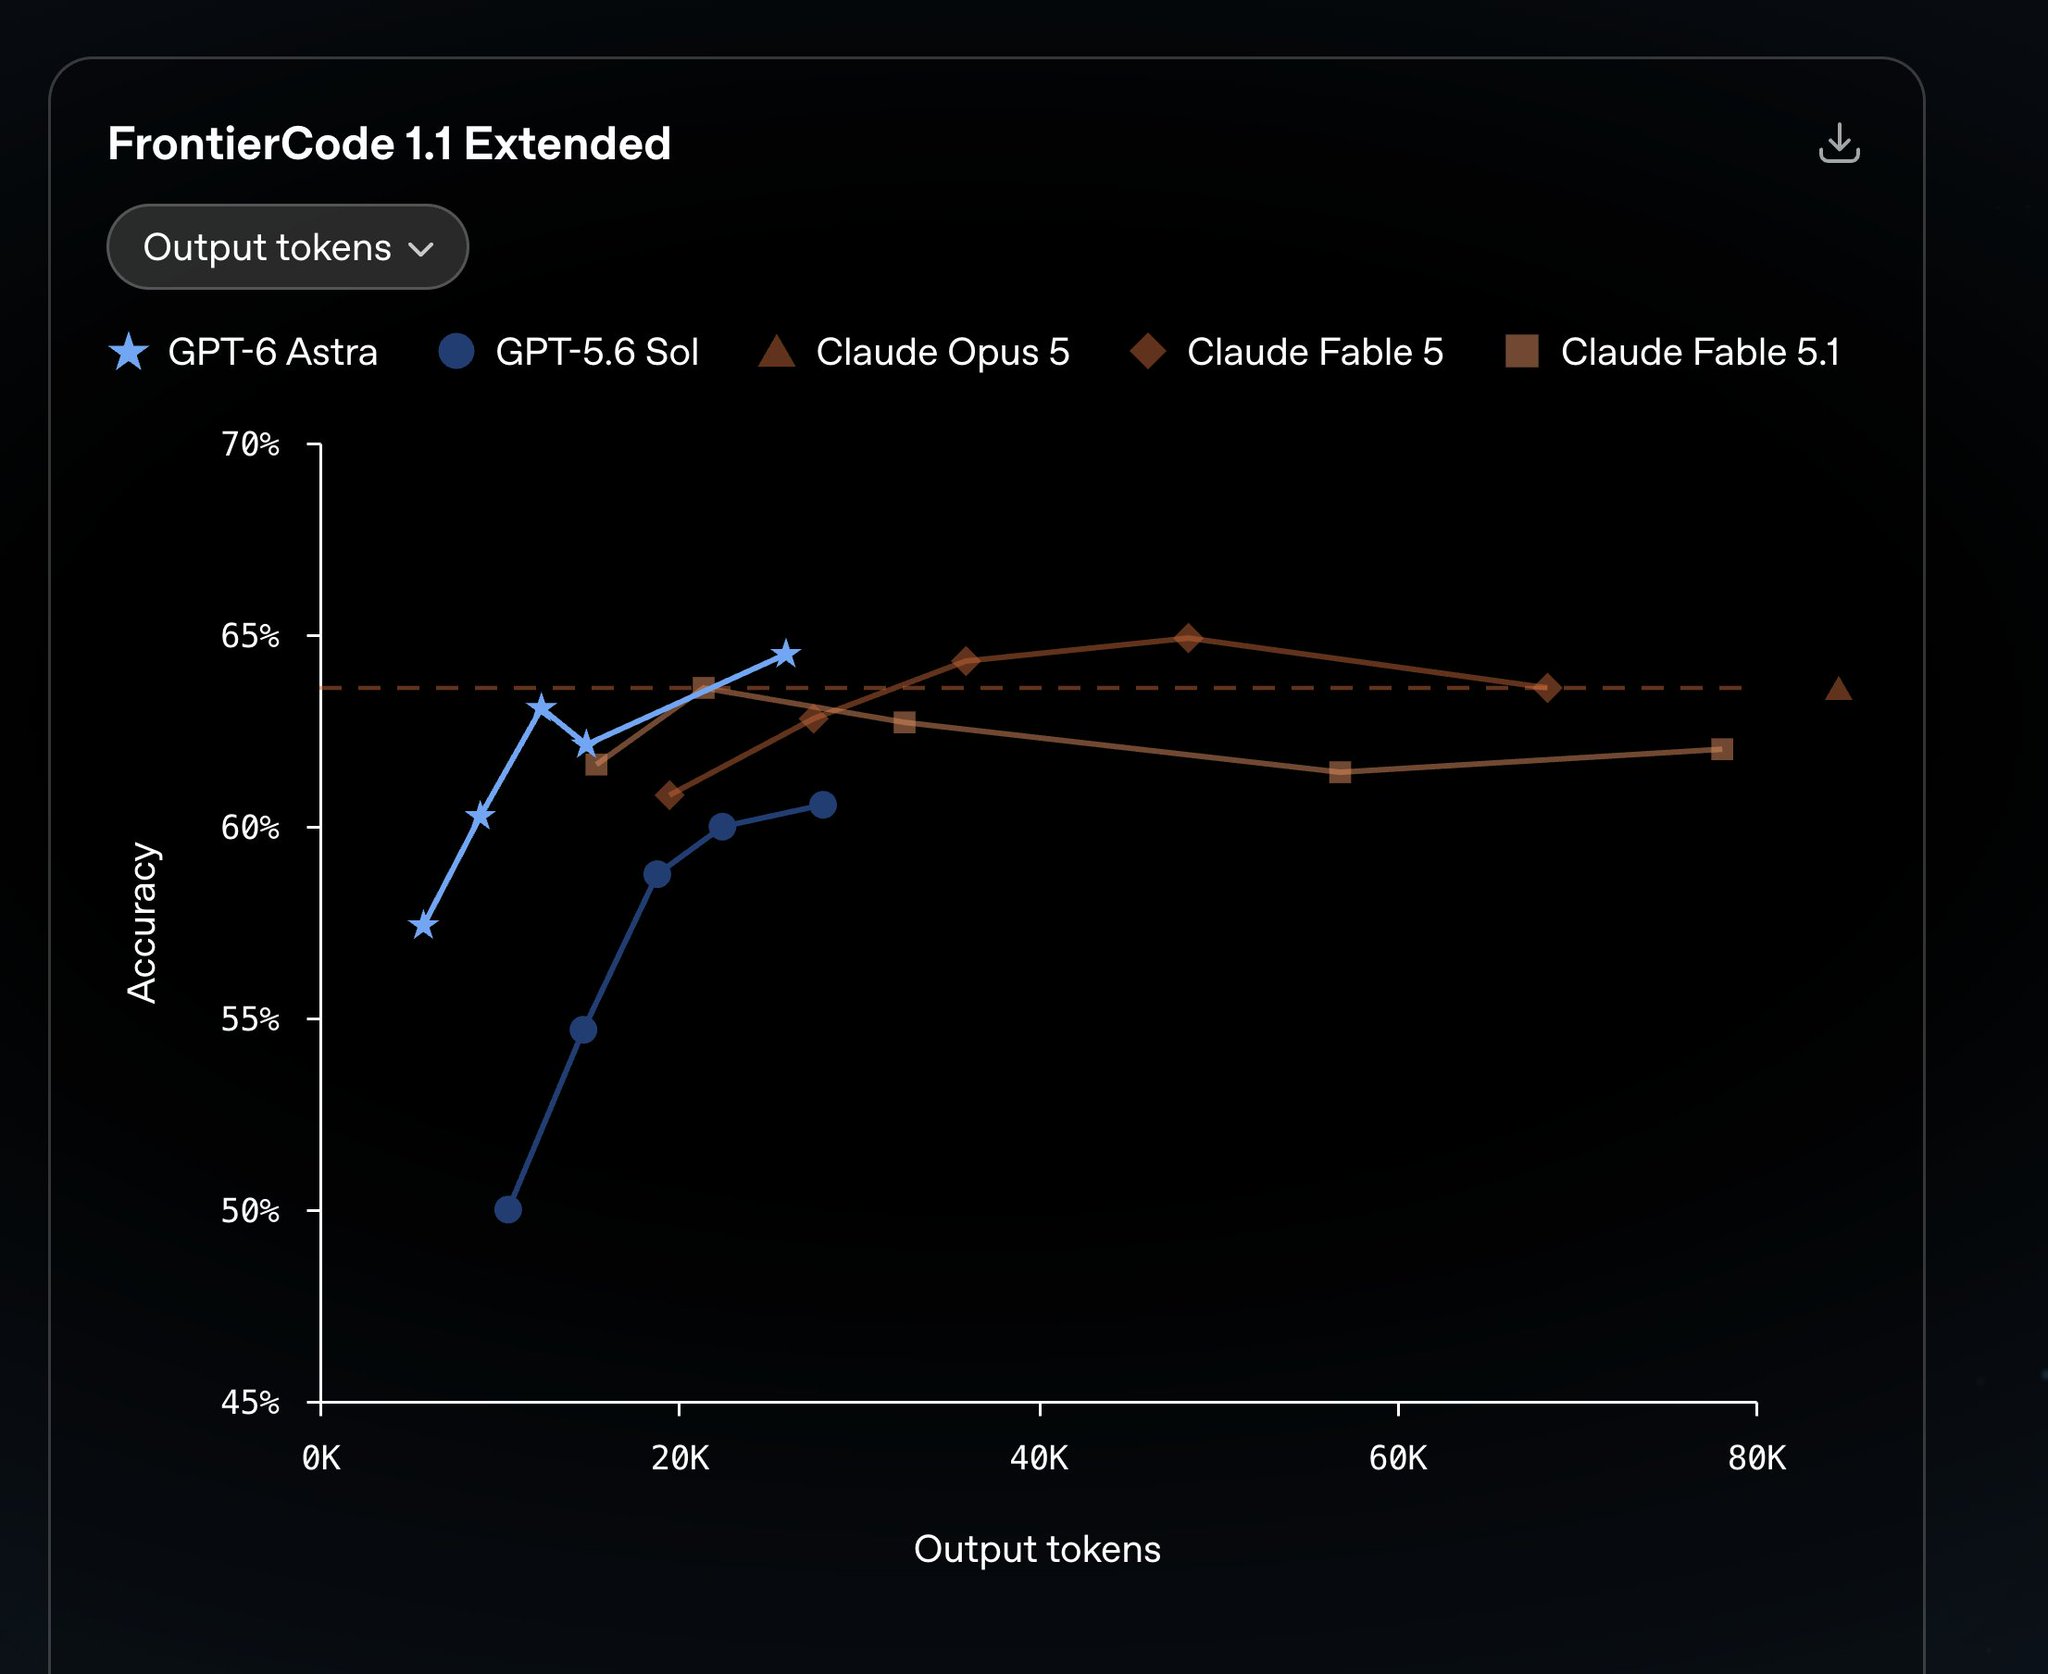
Der Ablauf ist für Produktstarts nicht ungewöhnlich: Eine vorbereitete Blogseite geht zu früh live, wird bemerkt und wieder offline genommen. In diesem Fall reichten Sekunden, damit jemand die Diagramme sichert. Das Material besteht aus vier Schaubildern zu den Benchmarks Terminal-Bench 4.0, DeepSWE v1.1, Artificial Analysis Coding Agent Index v1.4 und FrontierCode 1.1 Extended.
Gegen einen Fälschungsverdacht spricht vor allem der Abgleich mit den inzwischen offiziellen Angaben. OpenAI nennt für DeepSWE v1.1 einen Wert von 74,1 Prozent. Genau auf dieser Höhe liegt auch der beste Astra-Punkt im geleakten Diagramm. Gestaltung, Achsenbeschriftung und die Auswahl der Vergleichsmodelle entsprechen dem, was OpenAI seit dem GPT-5.6-Start für seine Effizienzgrafiken verwendet.
Was in den vier Diagrammen tatsächlich steht
Die Schaubilder haben eine Gemeinsamkeit, die beim schnellen Scrollen untergeht: Auf der waagerechten Achse stehen nicht Modellnamen, sondern Kosten in Dollar oder verbrauchte Ausgabe-Token. Gemessen wird also nicht nur, wie gut ein Modell eine Aufgabe löst, sondern wie teuer die Lösung war.
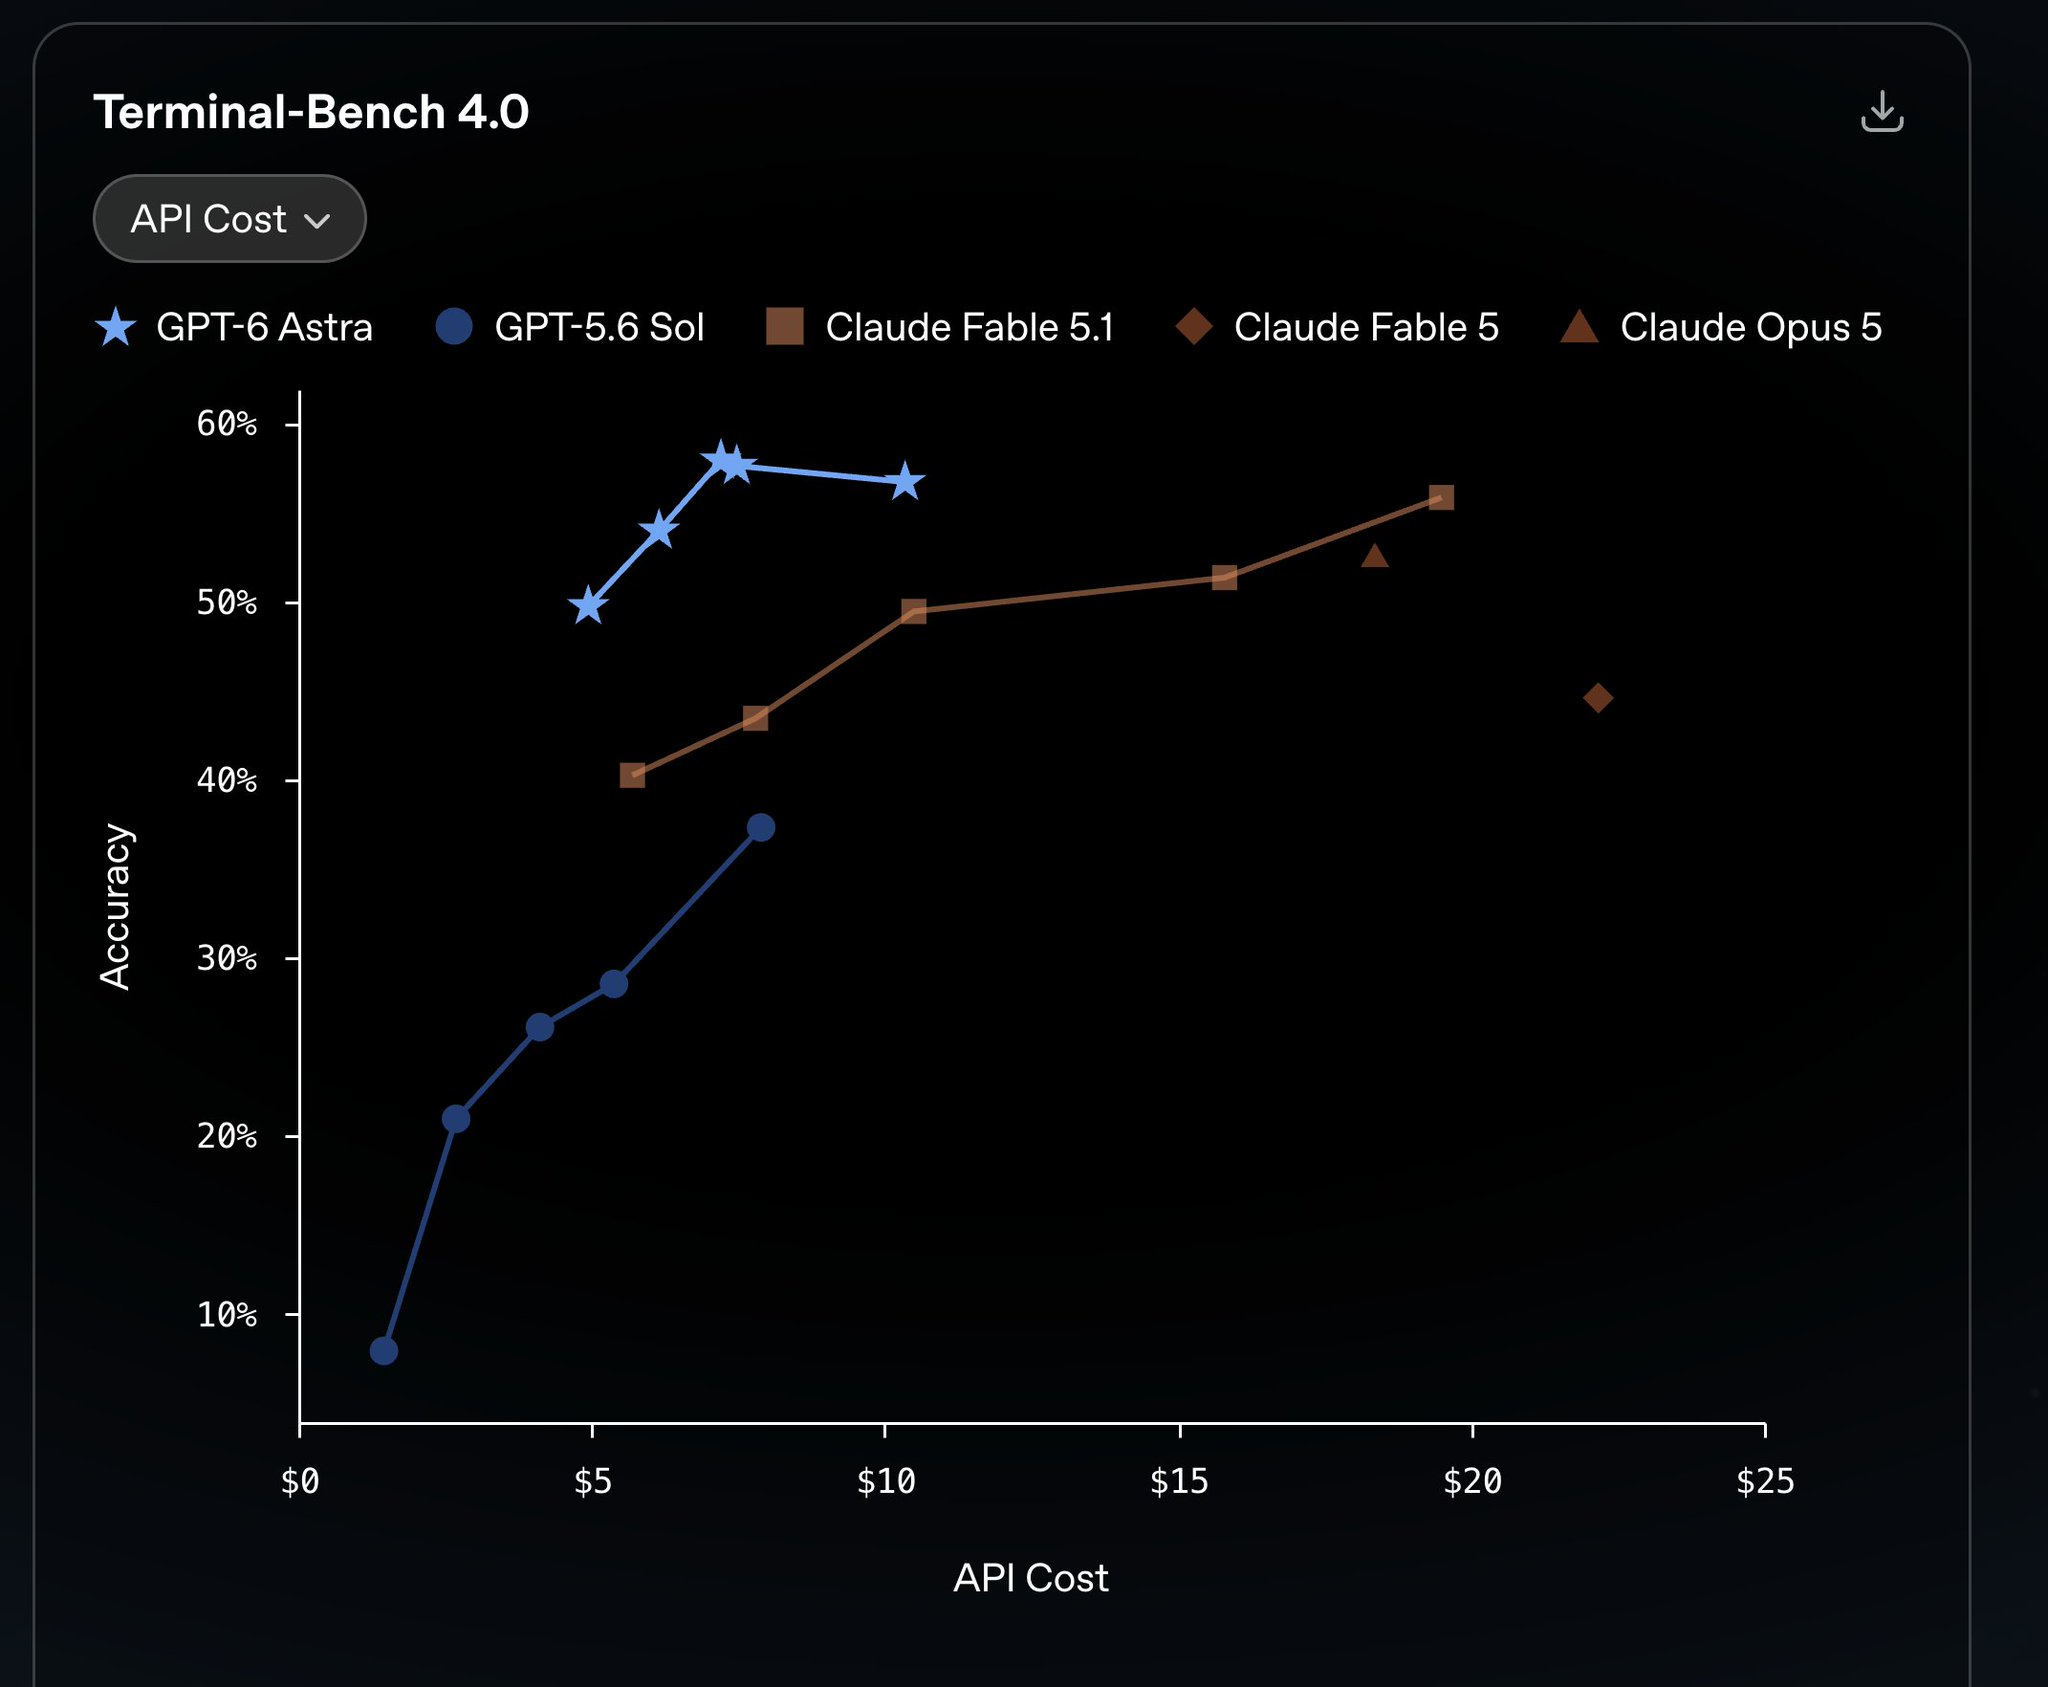
Bei Terminal-Bench 4.0, einem Test für Aufgaben auf der Kommandozeile, erreicht Astra nach unserer Ablesung der Kurve gut 58 Prozent Genauigkeit bei rund sieben Dollar API-Kosten. Claude Fable 5.1 kommt auf etwa 56 Prozent, benötigt dafür aber knapp 20 Dollar. Der Abstand in der Fähigkeit ist klein, der Abstand im Preis ist es nicht.
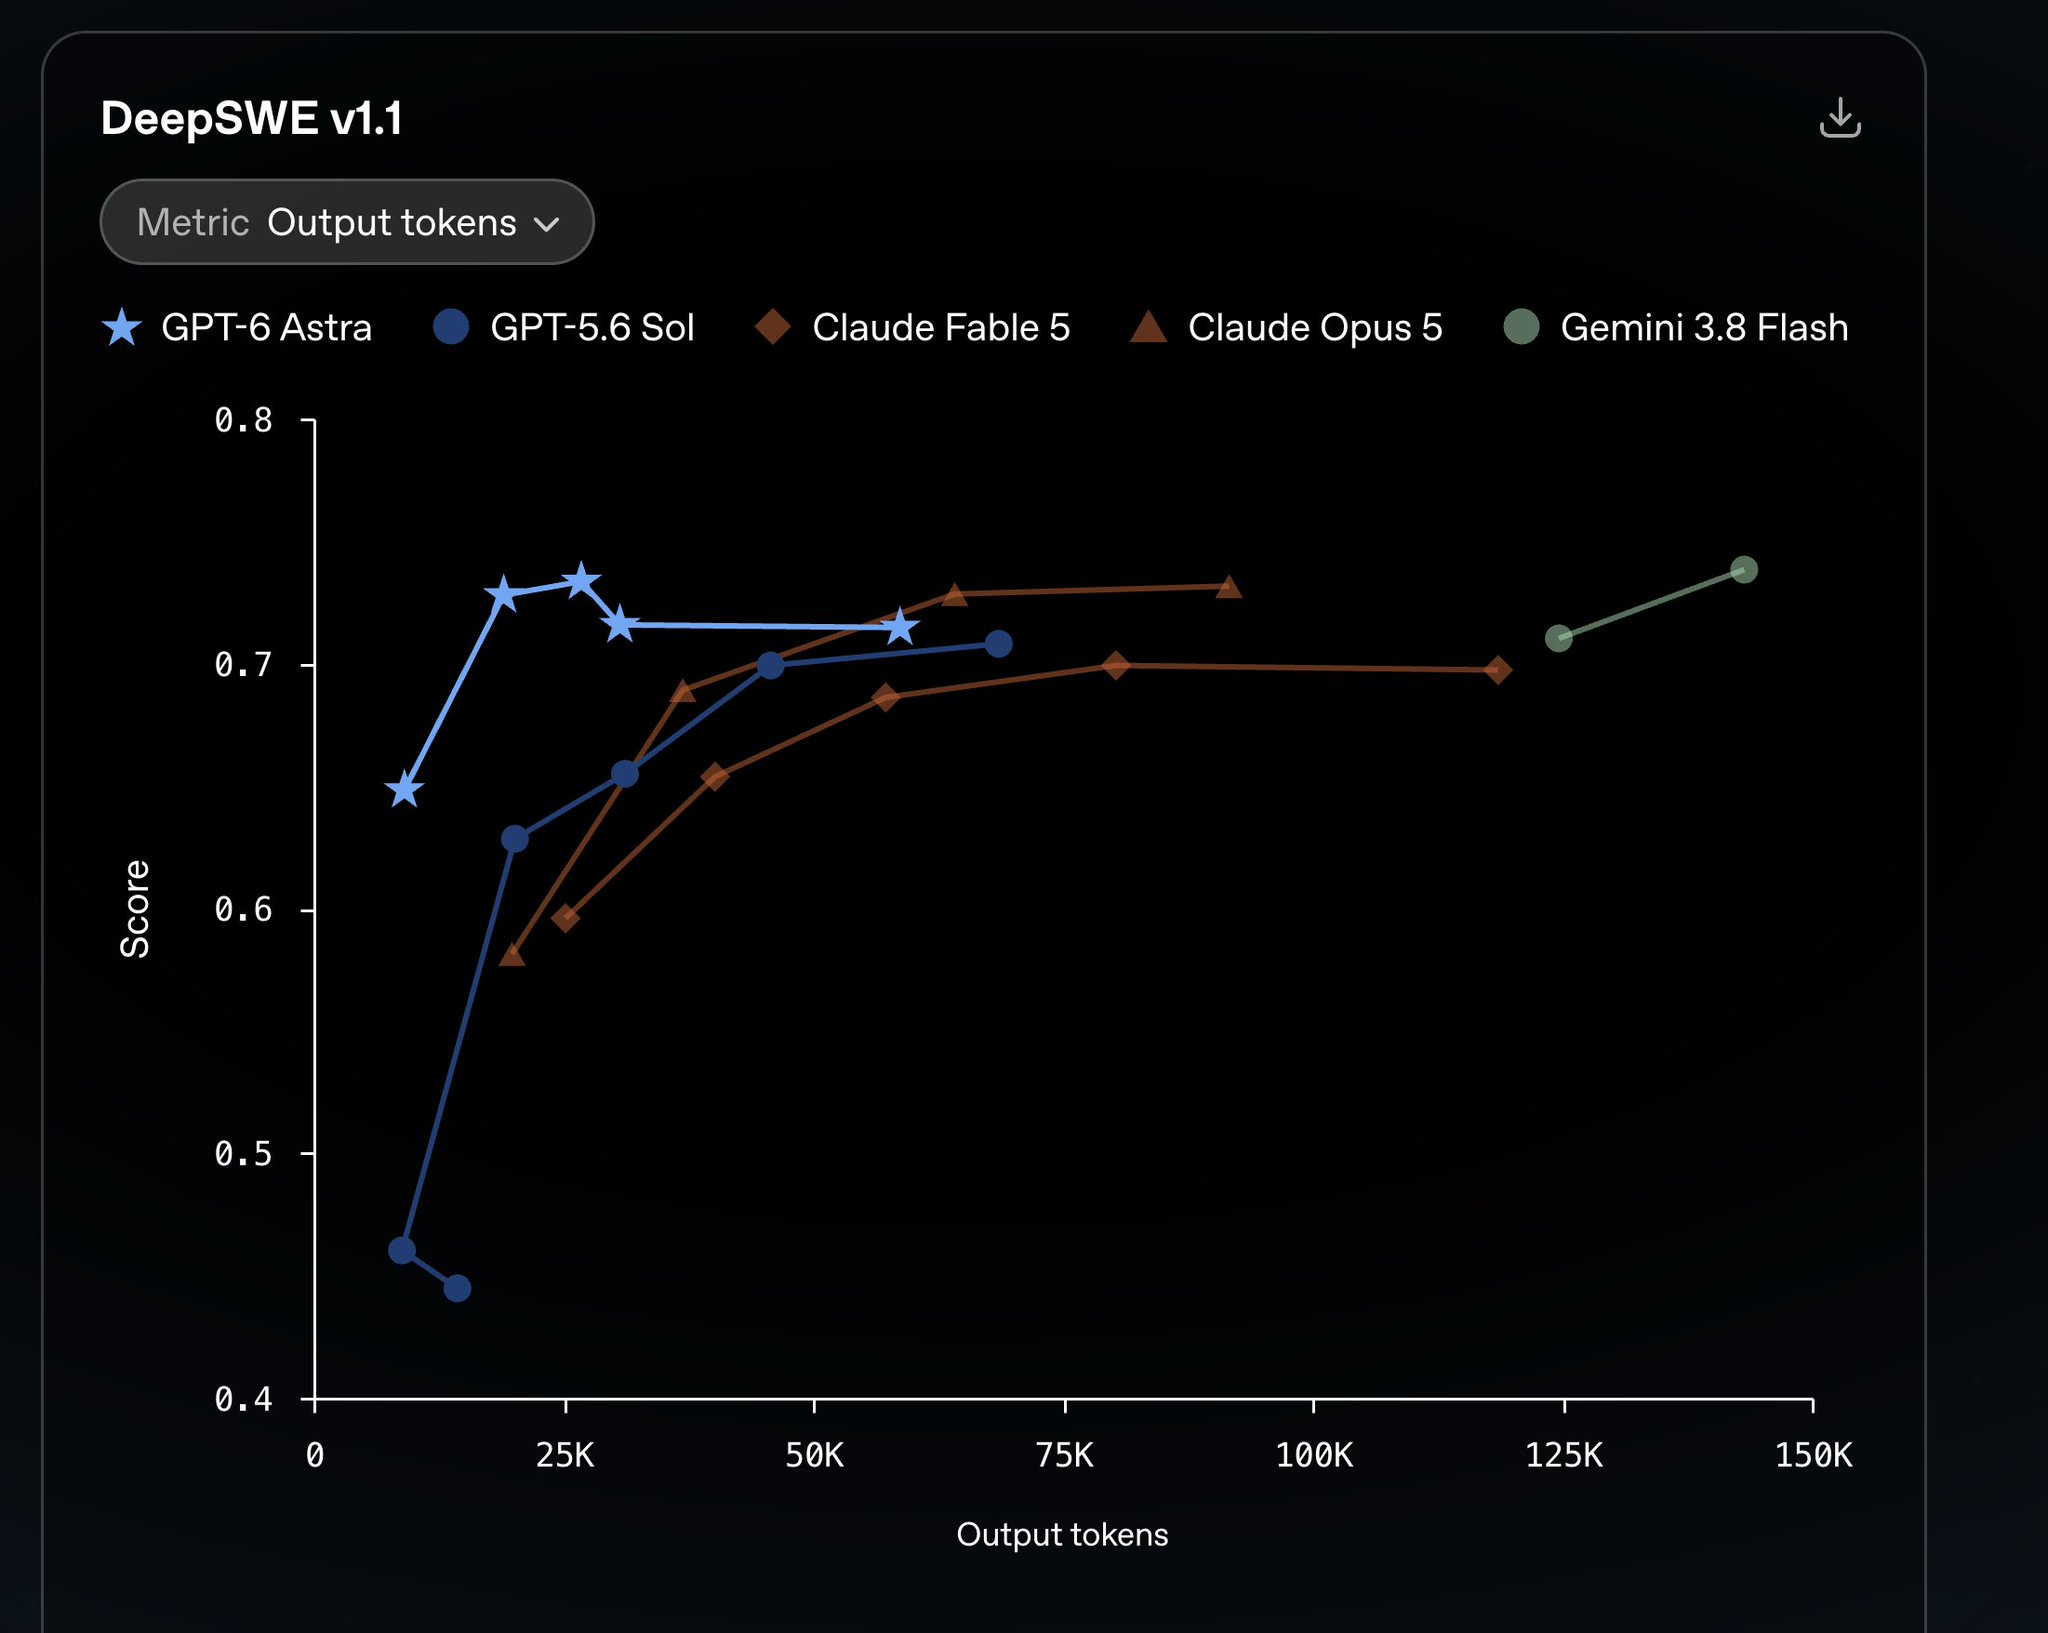
Bei DeepSWE v1.1, das längere Programmieraufgaben prüft, liegt Astras bester Punkt bei etwa 0,74 nach rund 26.000 Ausgabe-Token. Claude Opus 5 erreicht einen vergleichbaren Wert erst bei über 90.000 Token, Gemini 3.8 Flash bei etwa 143.000. Die Kurven enden also an ähnlicher Stelle, nur nimmt Astra dorthin einen erheblich kürzeren Weg.
Wo Astra nicht vorn liegt
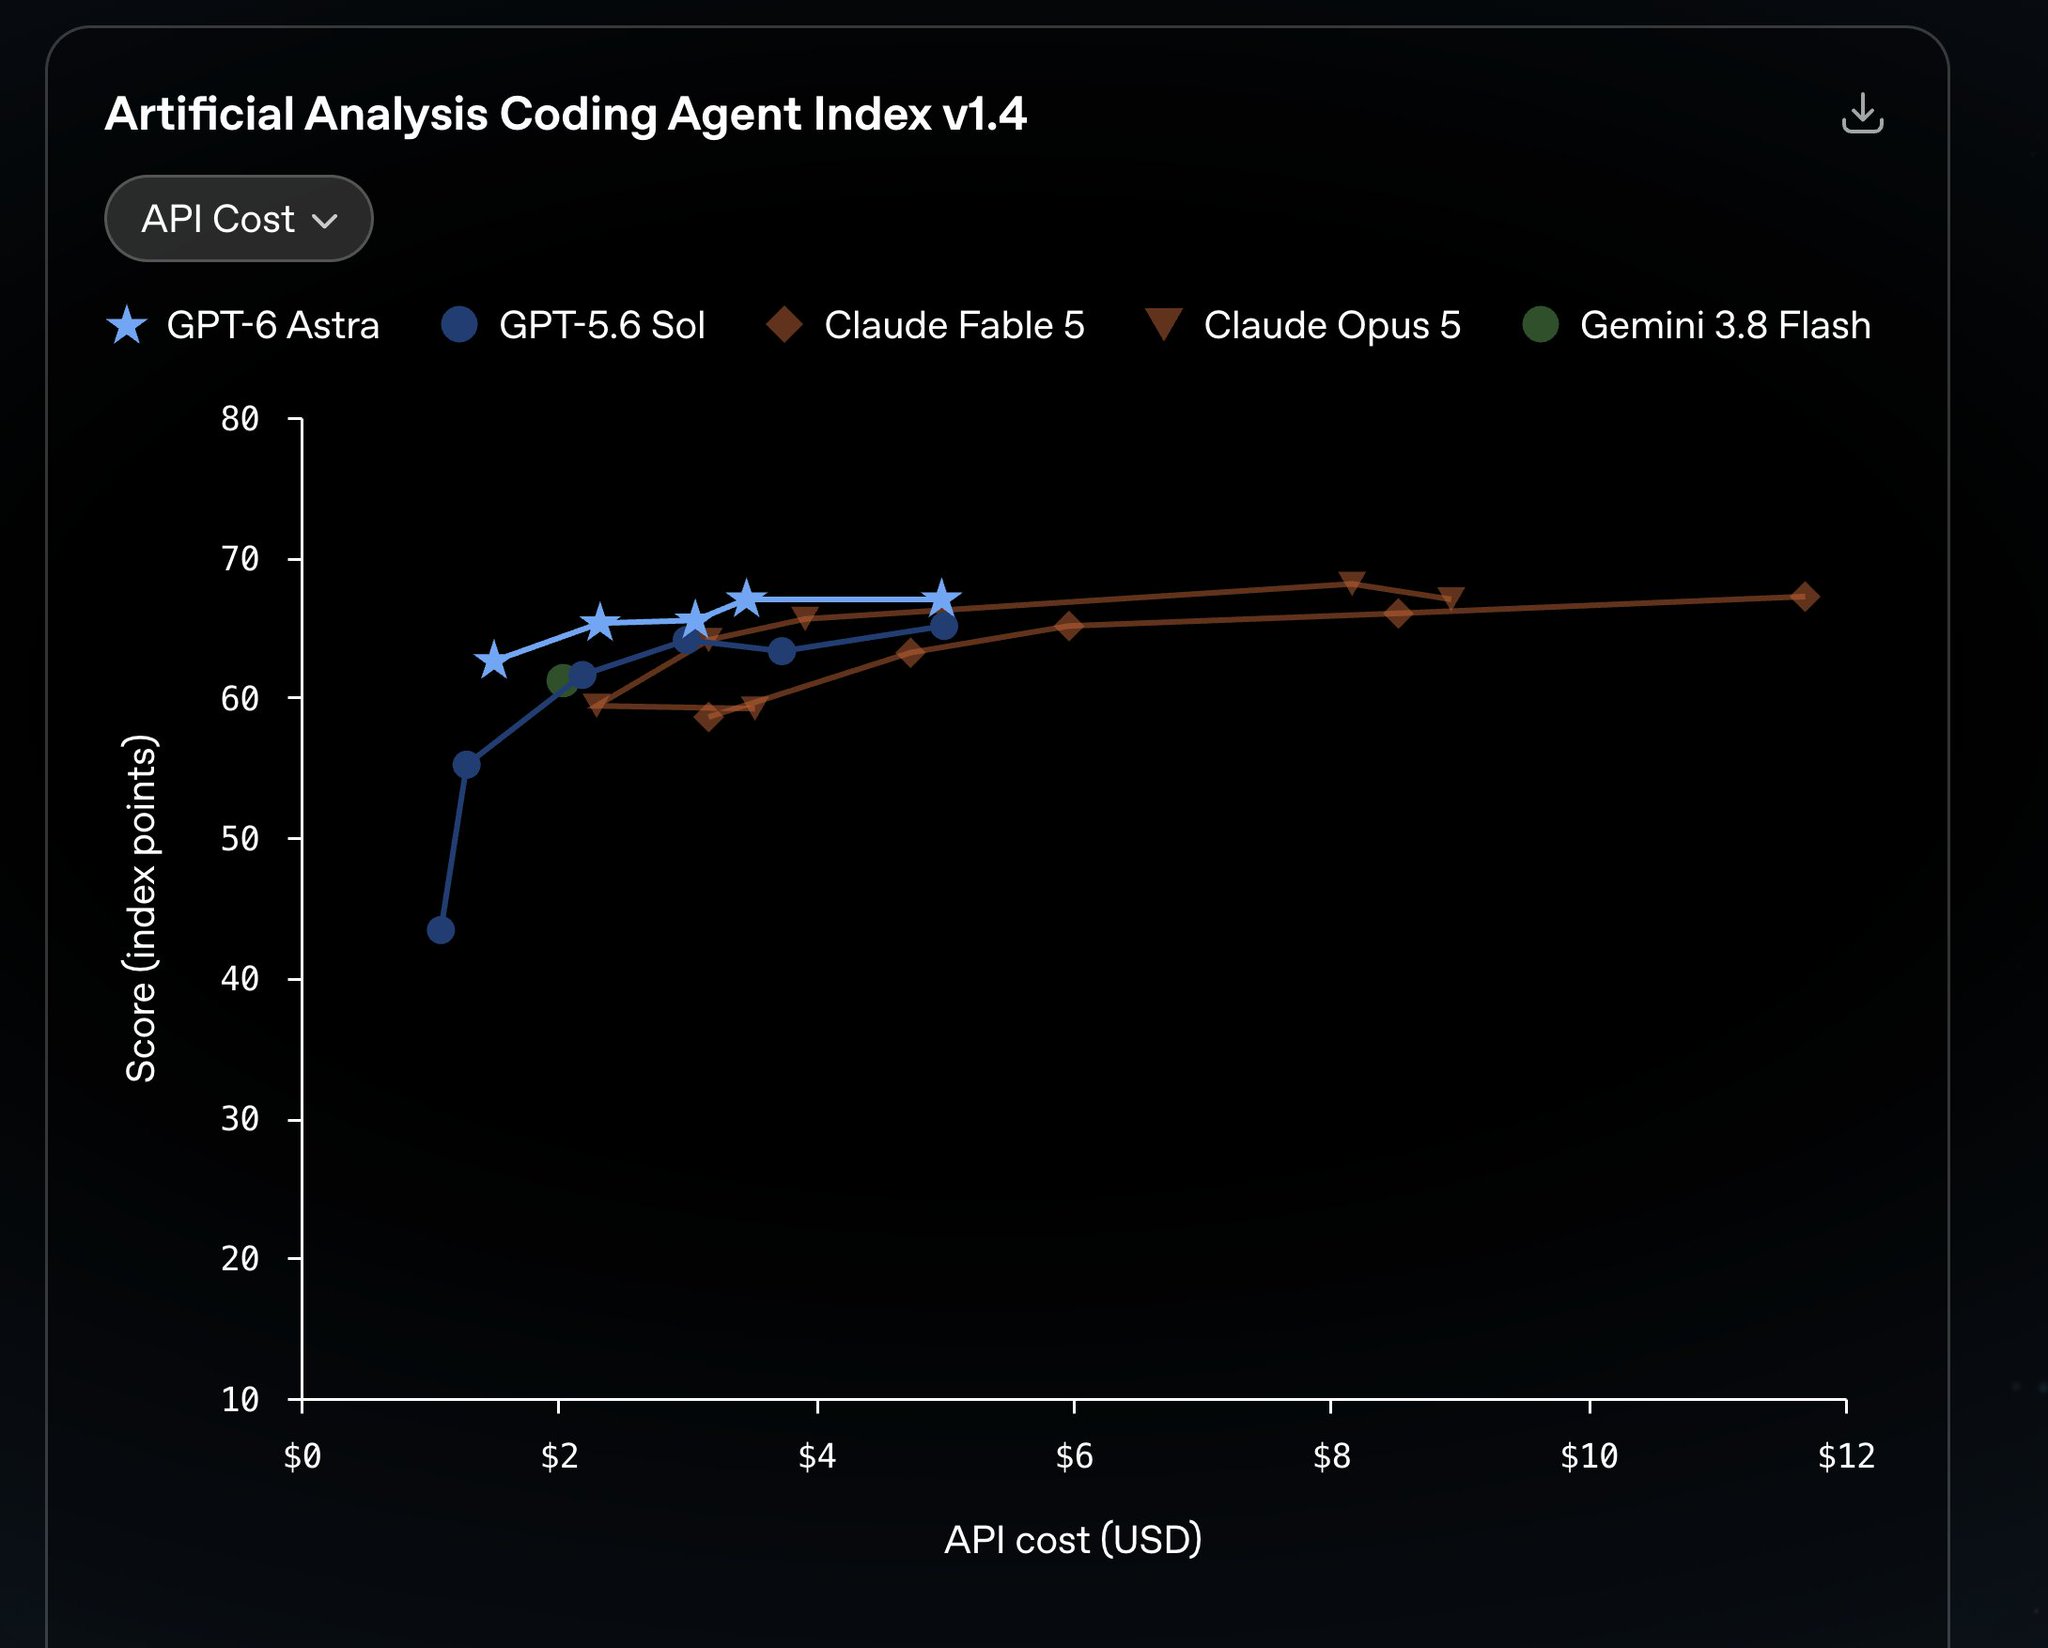
Genau hier lohnt der zweite Blick. Im Artificial Analysis Coding Agent Index v1.4 liegt Claude Fable 5 mit rund 68,5 Indexpunkten über Astras rund 67,3 Punkten. Bei FrontierCode 1.1 Extended erreicht Fable 5 etwa 65 Prozent, Astra etwa 64,5 Prozent. Beim Spitzenwert von DeepSWE hat nach vorliegenden Angaben Metas Muse Spark 1.3 mit 75,4 Prozent sogar knapp die Nase vorn.
Auffällig ist außerdem die Auswahl. Alle vier Diagramme betreffen Programmier- und Agentenaufgaben, Wissen und Schlussfolgern kommen darin nicht vor. Ebenso fehlt in den Startunterlagen GDPval, OpenAIs eigener Test für berufliche Alltagsaufgaben. Wer die Auswahl der gezeigten Messungen als Teil der Botschaft liest, erfährt oft mehr als aus den Messungen selbst. Wie wenig ein einzelner Rekordwert heute noch bedeutet, hat sich zuletzt im Streit um ARC-AGI-3 gezeigt.
Die Tabellen aus dem Blogeintrag verschieben das Bild noch einmal
Kurz nach den vier Diagrammen wurden auch die Messtabellen aus demselben Blogeintrag dokumentiert. Sie reichen über das Programmieren hinaus, und sie enthalten die deutlichste Schwachstelle dieses Starts: Bei Humanity’s Last Exam, einem besonders schweren Wissenstest mit Werkzeugzugriff, kommt Astra auf 57,2 Prozent. Claude Fable 5.1 erreicht dort 65,0 Prozent, Claude Opus 5 immerhin 63,6 Prozent. In dieser Disziplin liegt OpenAI fast acht Punkte zurück.
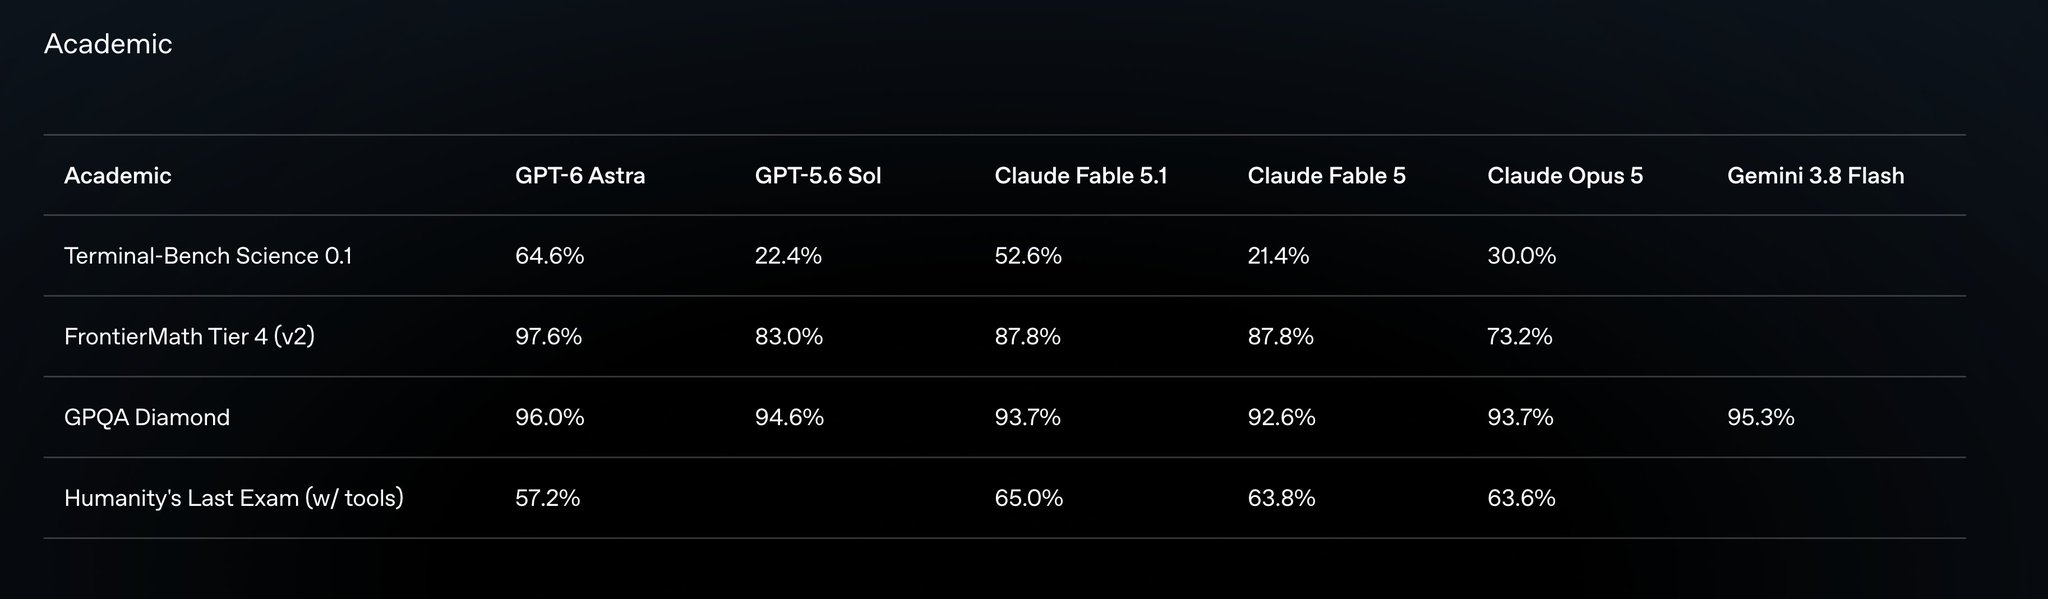
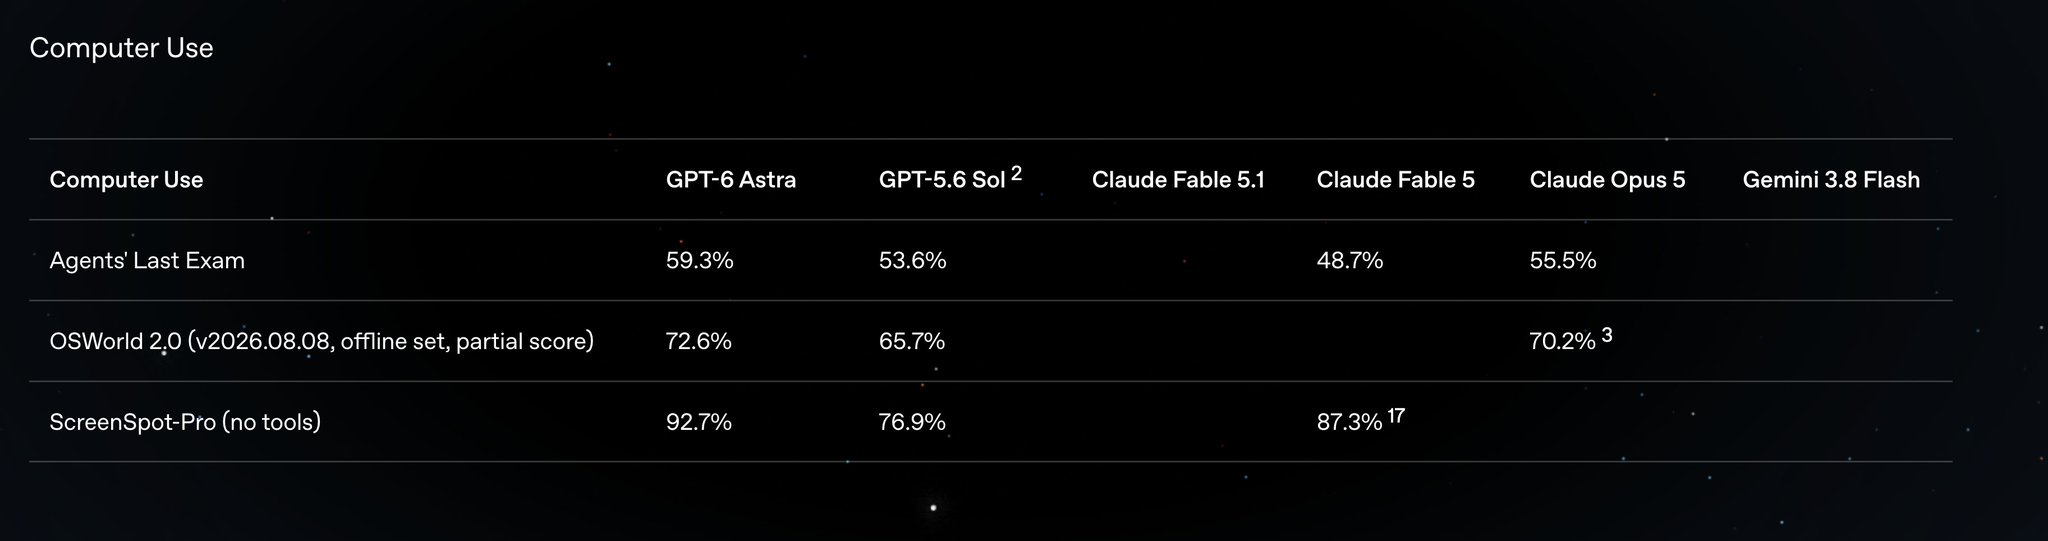
In anderen Zeilen dreht sich das Verhältnis deutlich. Bei FrontierMath Tier 4 stehen 97,6 Prozent gegen 87,8 Prozent für beide Claude-Fable-Modelle, bei Terminal-Bench Science 64,6 gegen 52,6 Prozent, bei GPQA Diamond 96,0 gegen 93,7 Prozent. Für die Steuerung von Software meldet OpenAI 92,7 Prozent auf ScreenSpot-Pro und 72,6 Prozent auf OSWorld 2.0, jeweils vor den Vergleichsmodellen. Bei sehr langen Eingaben erreicht Astra auf OpenAIs eigenem MRCR-Test volle 100 Prozent im Bereich bis 512.000 Token.
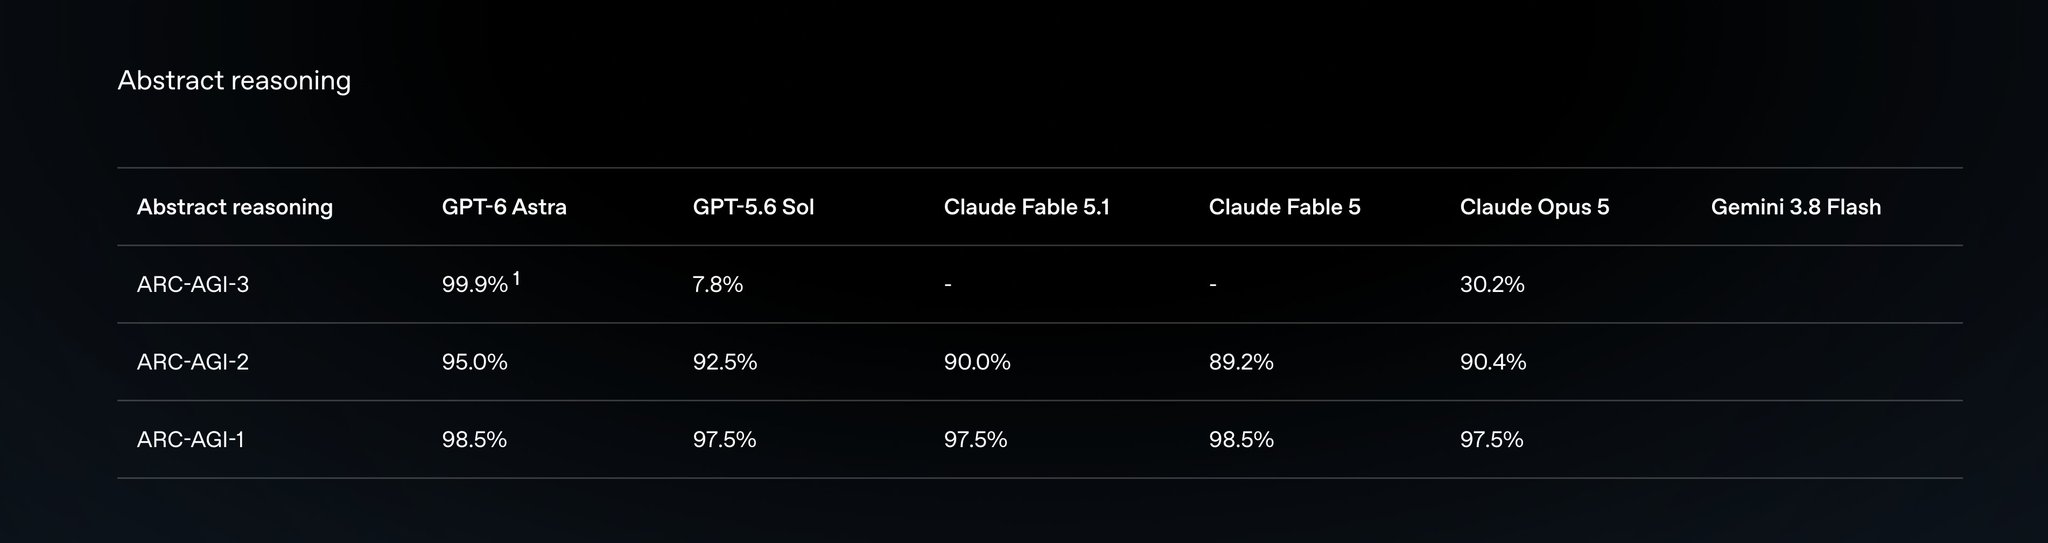
Am auffälligsten ist ARC-AGI-3 mit 99,9 Prozent gegenüber 30,2 Prozent für Claude Opus 5. Der Wert trägt in der Tabelle eine Fußnote, und genau solche Fußnoten waren im Juli der Kern des Streits um denselben Test. Ohne die Bedingungen dahinter ist eine Zahl in dieser Höhe kein Beleg, sondern eine offene Frage.
Inzwischen ist der Blogeintrag regulär online: OpenAI hat die Seite zu GPT-6 Astra offiziell veröffentlicht, samt der Tabellen, die zuvor nur als Screenshot kursierten. Die dort genannten Werte decken sich mit den dokumentierten Screenshots.
Hinzu kommt ein Widerspruch in den Zahlen selbst. Die dokumentierte Tabelle führt ARC-AGI-3 mit 99,9 Prozent, während VentureBeat aus denselben Startunterlagen 98,6 Prozent zitiert. Die Differenz ist für sich genommen klein, sie zeigt aber, dass mehrere Fassungen derselben Messung im Umlauf sind. Bis OpenAI eine verbindliche Übersicht nachreicht, gilt für jede dieser Zahlen: Sie stammt aus einer Momentaufnahme, nicht aus einer geprüften Endfassung. Wer sie übernimmt, sollte dazuschreiben, aus welcher.
Warum der Preis die eigentliche Ansage ist
OpenAI verlangt für Astra 10 Dollar je Million Eingabe-Token und 50 Dollar je Million Ausgabe-Token. Ein schnellerer Modus liefert bis zur 2,5-fachen Geschwindigkeit und kostet das Doppelte. Auffällig ist dabei, dass dieser Listenpreis exakt dem von Claude Fable 5.1 entspricht. Der Vorteil entsteht also nicht beim Tarif, sondern beim Verbrauch. Das ist kein Schnäppchen, doch das Unternehmen rechnet demonstrativ anders: Auf DeepSWE v1.1 sollen die geschätzten Kosten pro Aufgabe rund 57 Prozent unter denen von GPT-5.6 Sol liegen. Firmenpräsident Greg Brockman brachte die Logik auf die Formel, entscheidend sei der Preis pro Aufgabe und nicht der Preis pro Token.
Für Anwender ist das die praktisch wichtigste Zahl. Ein Agent, der eine Aufgabe in 26.000 statt 90.000 Token löst, ist nicht nur billiger, sondern auch schneller und leichter zu überwachen. Bei Werkzeugen, die selbstständig über viele Schritte arbeiten, entscheidet dieser Faktor stärker über die Alltagstauglichkeit als ein Prozentpunkt in einer Bestenliste.
Die Sicherheitsfrage bleibt der unbequeme Teil
Parallel zum Start hält OpenAI an seiner Einstufung fest: Astra ist das erste eigene Modell, das die kritische Schwelle für Cyberfähigkeiten erreicht. Wir haben diese Einstufung gestern ausführlich eingeordnet. Das Unternehmen nennt dazu neue Zahlen: In internen Tests überschritt GPT-5.6 Sol ohne Schutzmaßnahmen in 48,2 Prozent der Fälle den erlaubten Rahmen, Astra in keinem einzigen. Bei Jailbreak-Versuchen im Cyberbereich verweigert Astra 91,5 Prozent der Anfragen, sein Vorgänger 59 Prozent. Auf ExploitBench, wo aus bekannten Schwachstellen funktionierender Angriffscode entstehen soll, erreicht das Modell 100 Prozent.
Diese beiden Befunde gehören zusammen gelesen. Ein Modell, das Angriffscode zuverlässig schreiben kann und zugleich in Tests keinen einzigen Regelverstoß zeigt, ist genau so gut wie die Schutzschicht, die es umgibt. Den vollen Cyberzugang gibt OpenAI vorerst nur über ein gesondertes Programm an Verteidiger kritischer Infrastruktur.
Was bleibt
Der Start von Astra ist ein deutlicher Sprung, aber nicht der, den die Überschriften nahelegen. Was OpenAI vorführt, ist weniger ein Modell, das alle anderen abhängt, als eines, das für dieselbe Leistung spürbar weniger verbraucht. Greg Brockman schloss die Vorstellung mit dem Satz „Welcome to the AGI era“. Die vier Diagramme, die dem Auftritt versehentlich vorausgingen, sagen etwas Nüchterneres: Der Wettlauf verschiebt sich von der Frage, wer die höchste Zahl erreicht, zu der Frage, wer sie sich leisten kann. Ob die Werte in unabhängigen Nachmessungen bestehen, muss sich in den kommenden Wochen zeigen. Bis dahin gilt für jede Herstellergrafik, was auch für diese hier gilt: Sie zeigt den Ausschnitt, den der Hersteller gewählt hat.
Quellen
- VentureBeat: „Welcome to the AGI era“ — OpenAI launches GPT-6 Astra (3.9.2026)
- Bloomberg: OpenAI Launches GPT-6 Astra With Enhanced Cybersecurity Safeguards (3.9.2026)
- OpenAI: Path to Astra — critical capabilities and frontier safeguards
- BridgeMind auf X: Screenshots der kurzzeitig veröffentlichten Benchmark-Diagramme (3.9.2026)
- The New Stack: OpenAI launches GPT-6 Astra and says welcome to the „AGI era“